Paralelismo vs. Concorrência — Da Ideia ao Código C++
C++ · Concorrência · Performance
Duas tarefas em andamento. Mas quantas estão executando?
Adicionar threads é fácil. Entender o trabalho, a espera e a memória compartilhada é o que transforma isso em uma solução.
Você abre um aplicativo que baixa um arquivo enquanto responde aos seus cliques. Depois executa um programa que divide uma imagem entre vários núcleos para aplicar um filtro. Nos dois casos há mais de uma tarefa. O problema que cada programa resolve, porém, é diferente.
O primeiro precisa continuar útil enquanto parte do trabalho espera. O segundo quer terminar uma computação mais cedo. Confundir essas necessidades costuma produzir a mesma solução apressada: criar mais threads e torcer.
Vamos construir um modelo mental, escrever código e chegar a uma decisão de engenharia. Os exemplos completos usam C++20. Há também uma versão em inglês.
1. Concorrência organiza; paralelismo executa ao mesmo tempo
Seção intitulada “1. Concorrência organiza; paralelismo executa ao mesmo tempo”Concorrência é a organização de tarefas cujos períodos de progresso podem se sobrepor. Uma tarefa pode estar esperando enquanto outra avança. Isso pode acontecer com uma única thread, alternando etapas, ou com várias threads.
Paralelismo é execução simultânea de trabalho. Dois núcleos podem processar partes diferentes de uma imagem no mesmo instante. Também existe paralelismo de dados com instruções vetoriais; não se resume a criar threads.
Essa distinção entre composição de tarefas e execução simultânea é apresentada por Rob Pike em Concurrency is not parallelism, no blog oficial de Go. Ela continua útil quando a linguagem é C++.
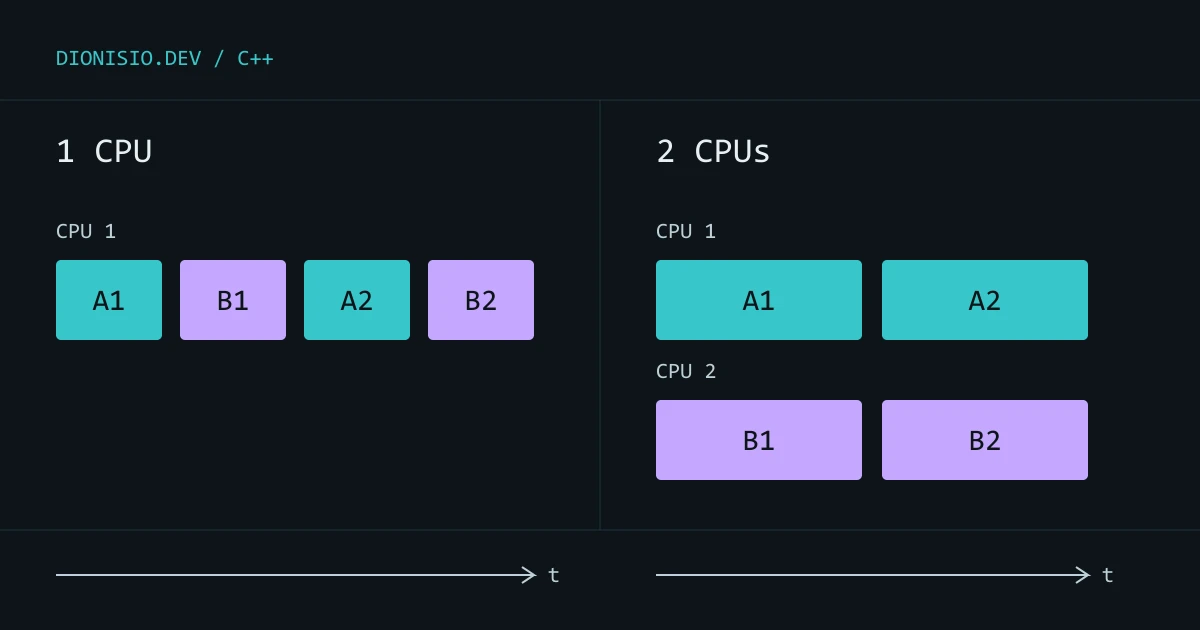
Tempo →Uma CPU:   [ A1 ][ B1 ][ A2 ][ B2 ]  tarefas intercaladas
Duas CPUs:CPU 1:     [ A1 ][ A2 ]CPU 2:     [ B1 ][ B2 ]              execução simultânea
O desenho omite custos e esperas. Não é um benchmark, nem significa que duas CPUs entregam exatamente o dobro da velocidade.
| Conceito | Pergunta principal | Exemplo |
|---|---|---|
| Concorrência | Como várias tarefas avançam sem exigir que uma termine antes de começar outra? | Atender conexões enquanto algumas aguardam dados |
| Paralelismo | Que trabalho pode executar simultaneamente? | Calcular blocos independentes em vários núcleos |
| Assincronismo | Como receber o resultado depois, sem esperar por ele nesta chamada? | Iniciar uma leitura e receber uma notificação de conclusão |
Assíncrono não significa paralelo. Uma API pode devolver o controle e concluir depois usando um event loop. Também pode usar um pool de threads. O nome da API não revela onde a computação acontece.
Em C++20, coroutines permitem suspender e retomar uma função, mas não fornecem por si só uma thread, um escalonador ou uma implementação de I/O. A biblioteca que integra a coroutine é parte essencial dessa história.
2. Concorrência sem criar threads
Seção intitulada “2. Concorrência sem criar threads”Este escalonador cooperativo de brinquedo mantém duas tarefas iniciadas e alterna seus passos. Cada tarefa guarda o próprio progresso:
// C++20 — cooperative.cpp#include <array>#include <cassert>#include <iostream>
struct Task {    char name;    int completed = 0;
    void step() {        ++completed;        std::cout << name << completed << ' ';    }};
int main() {    std::array<Task, 2> tasks{{{'A'}, {'B'}}};    for (int round = 0; round < 3; ++round) {        for (auto& task : tasks) task.step();    }    assert(tasks[0].completed == 3 && tasks[1].completed == 3);    std::cout << '\n';}
A saída é A1 B1 A2 B2 A3 B3. Só há uma thread: nenhum par desses passos executa simultaneamente. A concorrência está na decomposição do trabalho em tarefas que progridem por turnos.
O limite também fica claro: se step() bloquear por cinco segundos, a outra tarefa espera. Um event loop real precisa de etapas curtas e operações de I/O adequadas; apenas colocar uma função lenta em uma fila não a torna não bloqueante. Este exemplo ilustra escalonamento, não implementa uma biblioteca de I/O.
3. Trabalho independente em duas threads
Seção intitulada “3. Trabalho independente em duas threads”Agora queremos somar um milhão de inteiros. Dividimos a entrada em dois intervalos, acumulamos em variáveis locais e publicamos um resultado por trabalhador:
// C++20 — partitioned_sum.cpp#include <cassert>#include <cstddef>#include <cstdint>#include <iostream>#include <numeric>#include <thread>#include <vector>
int main() {    const std::vector<int> values(1'000'000, 1);    const auto middle = values.size() / 2;    std::int64_t left = 0;    std::int64_t right = 0;
    auto sum = [&values](std::size_t first, std::size_t last) {        std::int64_t result = 0;        for (auto i = first; i < last; ++i) result += values[i];        return result;    };
    std::jthread a([&] { left = sum(0, middle); });    std::jthread b([&] { right = sum(middle, values.size()); });    a.join();    b.join();
    const auto total = left + right;    const auto reference = std::accumulate(        values.begin(), values.end(), std::int64_t{0});    assert(total == reference && total == 1'000'000);    std::cout << total << '\n';}
Os intervalos não se sobrepõem; a entrada é somente leitura; cada saída tem um único escritor. O programa principal lê os resultados depois de join(), que espera a thread terminar e estabelece a sincronização necessária. Não precisamos de um mutex nesse desenho.
As threads podem executar em paralelo se houver recursos e o escalonador assim decidir. Em uma única CPU, podem apenas se intercalar. O código cria a oportunidade, não uma garantia de simultaneidade ou de ganho de desempenho.
std::jthread, disponível desde C++20, também faz a junção automaticamente ao ser destruída quando ainda está associada a uma thread. Aqui os join() explícitos marcam o ponto em que precisamos dos resultados. Sua solicitação de parada é cooperativa: não interrompe à força uma função que ignora o pedido. Veja o contrato de jthread no draft de C++.
As referências capturadas continuam válidas até ambas as threads terminarem. Em código real, cuide também das exceções: uma exceção que escapa da função de uma thread termina o processo; resultados e erros precisam de um canal definido.
4. O problema começa quando o estado é compartilhado
Seção intitulada “4. O problema começa quando o estado é compartilhado”Imagine trocar os dois resultados por um único total e fazer ++total em cada thread. Esse incremento envolve ler e modificar o mesmo objeto. Sem sincronização, acessos conflitantes potencialmente concorrentes, com pelo menos um não atômico e sem a ordenação exigida, podem constituir uma data race. Em C++, isso é comportamento indefinido — não apenas “às vezes o contador fica errado”. A regra está em intro.races.
Um std::atomic<int> resolve a atualização isolada de um contador. Ele não torna automaticamente correta uma operação composta, como “verificar saldo e depois sacar”. Duas threads podem verificar um saldo suficiente antes que qualquer uma o reduza, mesmo usando leituras e escritas atômicas separadas.
Para proteger essa regra de negócio, a verificação e a alteração precisam pertencer à mesma região protegida:
// C++20 — account.cpp#include <cassert>#include <mutex>#include <thread>
class Account {    std::mutex mutex_;    int balance_ = 100;public:    bool withdraw(int amount) {        if (amount <= 0) return false;        std::lock_guard lock(mutex_);        if (balance_ < amount) return false;        balance_ -= amount;        return true;    }
    int balance() {        std::lock_guard lock(mutex_);        return balance_;    }};
int main() {    Account account;    bool first = false;    bool second = false;    std::jthread a([&] { first = account.withdraw(80); });    std::jthread b([&] { second = account.withdraw(80); });    a.join();    b.join();    assert(first != second);    assert(account.balance() == 20);}
Um saque vence; não sabemos qual. A garantia é sobre o saldo, não sobre a ordem de atendimento. lock_guard libera o mutex ao sair do escopo, inclusive em um retorno antecipado.
Isso ajuda a separar data race, uma violação do modelo de memória, de race condition, um erro lógico que depende da ordem dos eventos. É possível eliminar a primeira e continuar com a segunda.
Mutexes também não resolvem tudo: duas threads esperando locks uma da outra podem entrar em deadlock. Evite chamar código desconhecido ou fazer I/O demorado segurando um lock. Sempre que possível, reduza o estado compartilhado antes de sofisticar a sincronização. As C++ Core Guidelines, seção CP, discutem essas escolhas.
5. Por que mais threads podem deixar tudo mais lento
Seção intitulada “5. Por que mais threads podem deixar tudo mais lento”O exemplo da soma demonstra correção, não aceleração. Somar inteiros é barato; criar threads e movimentar memória pode custar mais que a economia obtida. Em um serviço, costuma fazer mais sentido reutilizar um conjunto limitado de trabalhadores do que criar uma thread para cada item.
Um modelo simples ajuda: se 20% do tempo continuar estritamente sequencial e 80% puder ser dividido perfeitamente entre quatro trabalhadores, o ganho ideal será 1 / (0,20 + 0,80 / 4) = 2,5, não 4. Isso pressupõe trabalho fixo, divisão perfeita e custo adicional zero. Na prática ainda entram:
- Contenção: trabalhadores disputando o mesmo mutex ou recurso.
- Banda de memória: núcleos esperando dados, mesmo sem locks.
- False sharing: variáveis diferentes na mesma linha de cache provocando tráfego de coerência. Não é uma data race, mas pode custar caro.
- Tarefas pequenas: agendamento e comunicação maiores que o trabalho útil.
- Excesso de trabalhadores: mais threads executáveis disputando os recursos disponíveis.
As políticas de execução dos algoritmos, introduzidas em C++17, oferecem outra ferramenta: std::execution::par permite execução paralela, mas a implementação pode executar sequencialmente. par_unseq acrescenta restrições: não é um lugar para colocar arbitrariamente locks bloqueantes. Confira as regras das políticas no draft e o suporte da sua biblioteca antes de usar uma política como se fosse um botão de aceleração.
6. Como escolher e validar na prática
Seção intitulada “6. Como escolher e validar na prática”| Situação | Primeiro caminho a investigar |
|---|---|
| Muitas operações esperando rede | I/O assíncrono, timeouts e limite de operações em andamento |
| Computação pesada divisível | Particionar dados e medir com um número limitado de trabalhadores |
| Interface travando | Tirar trabalho longo da thread da interface; devolver resultados de forma segura |
| Um contador muito disputado | Acumular localmente e combinar; avaliar atomics se a operação realmente for isolada |
| Banco ou serviço externo saturado | Limitar demanda; adicionar threads pode piorar a fila |
Em produção, limite também o tamanho das filas. Quando a entrada supera a capacidade, backpressure significa desacelerar ou recusar trabalho antes que a memória e a latência cresçam sem controle. Defina quem cancela, quem espera o encerramento e quem recebe os erros.
Para executar cada exemplo, salve o bloco no arquivo indicado. Em uma instalação de GCC ou Clang com biblioteca C++20 compatível:
clang++ -std=c++20 -O2 -Wall -Wextra -pedantic -pthread partitioned_sum.cpp -o partitioned_sum./partitioned_sumTroque o nome para testar os outros programas. As saídas esperadas são A1 B1 A2 B2 A3 B3 e 1000000; o programa da conta termina sem saída quando as verificações passam. A disponibilidade de flags e do suporte a threads depende da plataforma.
Os três programas foram compilados e executados com GCC 13.1 (MinGW), em C++20. Se sua biblioteca não oferecer std::jthread, selecionar -std=c++20 não basta: confira também a implementação da biblioteca padrão instalada.
Antes de anunciar uma melhoria:
- Compare com uma versão sequencial correta, usando a mesma entrada e verificando o resultado.
- Meça o caminho que importa. Uma medição ponta a ponta deve incluir criação, sincronização e junção; se medir apenas o kernel, identifique essa diferença.
- Use
std::chrono::steady_clock, repita medições e registre hardware, compilador, otimização, tamanho da entrada e número de trabalhadores.sleep_fornão é benchmark de computação. - Observe throughput e latência, incluindo percentis sob carga. Uma média menor pode esconder uma fila pior.
- Procure data races com ThreadSanitizer em uma plataforma suportada. Ele analisa execuções observadas, não prova ausência de todos os erros; seu overhead também impede usar essa execução como benchmark de produção.
Exercício: adapte a soma para tamanhos ímpares e entrada vazia. Depois varie o tamanho dos dados e compare a versão sequencial com dois trabalhadores. Encontre o ponto em que o custo de coordenação compensa — ou registre que, na sua máquina e nesse trabalho, ele não compensou.
Conclusão: comece pelo trabalho, não pela thread
Seção intitulada “Conclusão: comece pelo trabalho, não pela thread”Concorrência permite organizar tarefas que avançam em períodos sobrepostos. Paralelismo permite executar trabalho simultaneamente. Assincronismo descreve como uma operação entrega o resultado depois. Um sistema pode combinar os três, mas cada escolha precisa resolver uma necessidade concreta.
Meu ponto de partida seria: identificar espera e computação, definir ownership, dividir o que é independente e tornar explícitos os pontos de sincronização. Só então escolher threads, tarefas ou um event loop. A melhor quantidade de threads é a que sustenta o comportamento correto e o desempenho medido do seu sistema.
Referências e próximos passos
Seção intitulada “Referências e próximos passos”- Go Blog — Concurrency is not parallelism: distinção conceitual e palestra de Rob Pike.
- C++ Working Draft —
jthread, data races e políticas de execução: contratos da linguagem e biblioteca. O draft evolui; os exemplos aqui usam apenas recursos de C++20 ou anteriores. - C++ Core Guidelines — Concurrency and parallelism: orientação de projeto e revisão.
- Clang — ThreadSanitizer: uso, plataformas e limitações da ferramenta.
- No site: C++ por versão, cache affinity e trilha prática de C++.