C# e C++ no Mesmo Processo — CLR, C++/CLI e a Fronteira Nativa
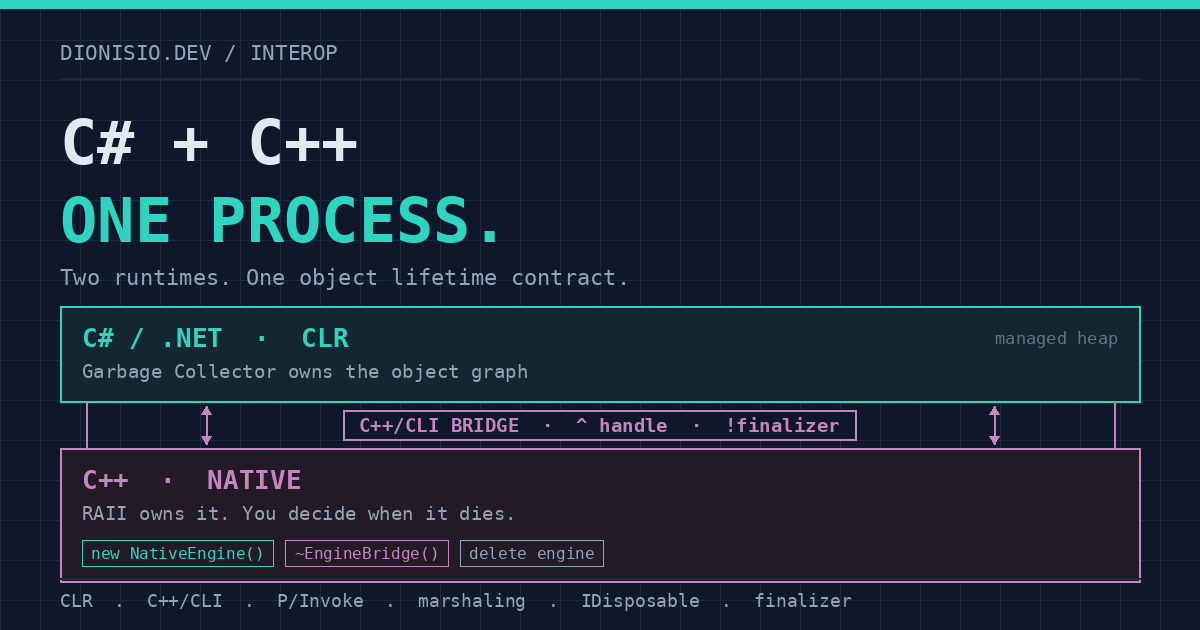
C++ · C# · .NET · Interoperabilidade
Dois runtimes. Um objeto. Ninguém combinou quem o mata.
Interop não é a arte de fazer duas linguagens conversarem. É a arte de fazer dois modelos de execução concordarem sobre tipos, erros, memória e tempo de vida de objetos — antes que a produção encontre a discordância por você.
Você entrega uma aplicação desktop Windows. A interface é C#. Os cálculos que realmente importam rodam numa biblioteca C++ que está na empresa há mais tempo do que a maior parte do time.
O usuário clica num botão. Um evento nasce no mundo gerenciado do .NET, atravessa uma camada intermediária e aterrissa num objeto C++ que não sabe nada sobre coletor de lixo.
A função roda, devolve um valor, a UI repinta.
Simples — até um objeto ser destruído uma instrução cedo demais, uma exceção C++ sair do mundo nativo por uma porta que ninguém construiu para carregá-la, ou o processo continuar crescendo depois que a janela fecha.
Há uma versão em inglês.
O fio condutor de todas essas falhas é o mesmo: a fronteira foi tratada como encanamento em vez de arquitetura. Um ponto de chamada é encanamento. Um contrato de tempo de vida é arquitetura. A maior parte do código de interop que existe por aí tem o primeiro e improvisa o segundo.
1. O Que o CLR Realmente É
Seção intitulada “1. O Que o CLR Realmente É”CLR — Common Language Runtime — é o ambiente de execução gerenciado por trás do .NET.
C# é compilado para uma representação intermediária (CIL), e o runtime assume dali — JIT na primeira chamada, compilação em camadas conforme o método esquenta, AOT em alguns modelos de implantação. O trabalho do compilador termina antes de o código de máquina existir. É essa a parte que as pessoas esquecem quando esperam que async ou um try/catch se comportem como no código nativo.
O CLR fornece:
- Gerenciamento de memória por meio de um coletor de lixo tracing
- Um sistema de tipos com metadados, reflexão e IL verificável
- Tratamento de exceções gerenciado com desenrolar de pilha guiado por esses metadados
- Carregamento, versionamento e binding de assemblies
- Integração entre linguagens para todo idioma que mira o runtime
O C++ nativo não está nesse clube. Seus objetos seguem o modelo da linguagem: construtores e destrutores, alocadores, RAII e regras explícitas de ownership que o compilador impõe em tempo de compilação, não em tempo de execução.
A diferença fundamental:
Em C#, o runtime decide quando a memória de um objeto é recuperada. Em C++ nativo, o seu código decide quando os recursos dele são liberados — e o compilador cobra isso de você.
Essa frase não é a afirmação de que C# não tem limpeza (tem IDisposable, using, finalizadores) nem de que C++ é só new/delete manual (tem unique_ptr). É uma afirmação sobre qual sistema é dono da decisão. Quando você conecta os dois mundos, está conectando dois sistemas que acreditam ser os responsáveis.
2. A Arquitetura Que Costuma Funcionar
Seção intitulada “2. A Arquitetura Que Costuma Funcionar”Imagine uma ferramenta de cálculo de engenharia. A casca é Windows Forms ou WPF; o solucionador é uma biblioteca C++ já existente.
┌───────────────────────────────┐│ Aplicação Desktop ││ C# / .NET ││ ││ UI, eventos, apresentação │└──────────────┬────────────────┘ │ chamada gerenciada ▼┌───────────────────────────────┐│ Camada de Interop ││ C++/CLI ││ ││ Tipos, erros, tempo de vida │└──────────────┬────────────────┘ │ chamada nativa ▼┌───────────────────────────────┐│ Engine Nativa ││ C++ ││ ││ Algoritmos e regras de domínio│└───────────────────────────────┘A aplicação C# nunca vê a implementação C++. Ela vê um contrato gerenciado.
A camada do meio adapta chamadas, converte tipos quando necessário, traduz falhas e é dona dos recursos nativos.
O valor dessa separação não é organização. É raio de explosão. Se a biblioteca C++ mudar suas entranhas no próximo trimestre — novo solucionador, estratégia de alocação diferente — o impacto fica dentro da bridge, desde que o contrato público se mantenha. Sem essa camada, cada formulário e cada view model que tocou a engine se torna um lugar onde um refactor nativo pode quebrar.
Uma regra faz ou desfaz esse desenho: a bridge não é uma saída de emergência de uso geral. No momento em que você expõe um NativeEngine* para o lado C# “só para este caso”, você moveu a questão de ownership para a camada de UI e a camada deixou de se pagar.
3. C++/CLI Não É C++
Seção intitulada “3. C++/CLI Não É C++”C++/CLI é uma extensão da Microsoft ao C++ para trabalhar com tipos gerenciados do .NET. Ela deixa código nativo e código gerenciado coexistirem dentro de uma mesma unidade de tradução — o que é justamente o motivo de ser a bridge mais conveniente, e justamente o motivo de ser o lugar mais fácil de escrever um híbrido impossível de manter.
Dois construtos mostram a divisão de imediato:
// Objeto nativo — o tempo de vida é seuNativeEngine* engine = new NativeEngine();
// Handle para um objeto gerenciado — o GC decide quando ele someSystem::String^ name = gcnew System::String("Engine");
O ^ é um handle para um objeto gerenciado, não um ponteiro. Ele é rastreado pelo GC, e ele se move — o runtime o atualiza quando os objetos se deslocam durante a compactação. Tratá-lo como ponteiro (guardá-lo em memória nativa, fazer aritmética com ele) é comportamento indefinido que costuma parecer perfeito nas builds de debug.
gcnew aloca no heap gerenciado. ref class declara um tipo de referência gerenciado:
public ref class EngineBridge{public: double Calculate(double value, double factor);};value class daria a você um tipo de valor gerenciado com semântica de pilha para payloads pequenos e copiáveis — vale saber, porque passar um struct pela fronteira por referência gerenciada quando você queria um valor é um custo real (e silencioso).
Um detalhe que morde quem vem de C++ moderno: a metade gerenciada do C++/CLI tem restrições próprias. Não assuma que toda feature de C++20 ou C++23 está disponível dentro de uma ref class. Constraints, concepts e parte da maquinaria de templates se comportam diferente ou não existem ali. Teste a feature específica, não presuma.
4. Construindo um Exemplo Realista
Seção intitulada “4. Construindo um Exemplo Realista”Três componentes, deliberadamente pequenos:
- Uma biblioteca C++ nativa.
- Uma DLL C++/CLI que a expõe ao .NET.
- Uma aplicação C# consumindo a DLL.
4.1. A biblioteca nativa
Seção intitulada “4.1. A biblioteca nativa”NativeEngine.h:
#pragma once
#include <stdexcept>
class NativeEngine{public:    double Calculate(double value, double factor) const    {        if (factor <= 0.0)        {            throw std::invalid_argument(                "Factor must be greater than zero"            );        }
        return value * factor;    }};
C++ puro. Sem CLR, sem referências de assembly, sem UI. Compilável e testável sozinho, em qualquer plataforma.
Esse é o primeiro objetivo arquitetural: manter a lógica de domínio independente de qualquer tecnologia que a apresente.
4.2. A bridge
Seção intitulada “4.2. A bridge”EngineBridge.h:
#pragma once
#include "NativeEngine.h"
using namespace System;
namespace Interop{    public ref class EngineBridge    {    private:        NativeEngine* engine;
    public:        EngineBridge()            : engine(new NativeEngine())        {            // If this throws and we are already constructed-adjacent,            // a finalizer may still run on an uninitialized field.            // `engine` is initialized in the member list, so the value is            // defined — but a null check in the finalizer remains mandatory.        }
        double Calculate(double value, double factor)        {            if (engine == nullptr)            {                throw gcnew ObjectDisposedException(                    "EngineBridge"                );            }
            try            {                return engine->Calculate(value, factor);            }            catch (const std::invalid_argument& ex)            {                throw gcnew ArgumentException(                    gcnew String(ex.what())                );            }            catch (const std::exception& ex)            {                throw gcnew InvalidOperationException(                    "Native engine operation failed",                    gcnew Exception(gcnew String(ex.what()))                );            }        }
        ~EngineBridge()        {            this->!EngineBridge();        }
        !EngineBridge()        {            delete engine;            engine = nullptr;        }    };}
Três coisas estão acontecendo aqui, e cada uma delas é uma decisão, não boilerplate.
Primeiro: uma classe gerenciada é dona de um recurso nativo. Esse é o problema estrutural em miniatura. EngineBridge vive no mundo .NET; NativeEngine veio de um new e jamais será tocado pelo GC. O coletor consegue ver a referência para a bridge e sabe quando a bridge é lixo. Ele não consegue enxergar através de engine para saber o que liberá-lo significa — ele não tem ideia se liberar implica delete, CloseHandle, fclose ou devolver ao pool. Então você informa, por um caminho determinístico.
Segundo: a bridge traduz erros. std::invalid_argument vira System::ArgumentException. Agora o consumidor C# pode escrever um catch que significa algo.
Em produção a política precisa ser mais cuidadosa do que este exemplo: registrar com contexto, separar falhas esperadas das inesperadas, preservar informação de diagnóstico sem vazar dados sensíveis numa mensagem que o usuário vai ver. E note o catch (...) deliberadamente ausente aqui — mais sobre isso na seção 9.
Terceiro: existe uma política explícita de destruição. Em C++/CLI, ~EngineBridge() é o destrutor de uma ref class — é o que implementa Dispose() para consumidores .NET. !EngineBridge() é o finalizador, o caminho não determinístico que o GC invoca.
O destrutor chama o finalizador para que a liberação nativa viva em exatamente um lugar. Atribuir engine = nullptr em seguida torna a limpeza idempotente — e você precisa disso, porque Dispose() seguido de finalização é normal, não excepcional. Toda bridge que você escrever será descartada duas vezes. Projete para isso ou depure por causa disso.
O consumidor ideal sempre libera explicitamente, via using. O GC existe como rede de segurança para o caso de alguém esquecer, não como o caminho de liberação pretendido.
4.3. Consumindo de C#
Seção intitulada “4.3. Consumindo de C#”using System;using Interop;
public class Program{ public static void Main() { using var engine = new EngineBridge();
try { double result = engine.Calculate(100, 1.25);
Console.WriteLine($"Result: {result}"); } catch (ArgumentException ex) { Console.WriteLine($"Invalid input: {ex.Message}"); } }}C# nunca vê um NativeEngine*. Vê uma classe que expõe Calculate() e participa de IDisposable. O using dá liberação determinística na saída do escopo — inclusive quando a exceção é lançada.
Esse using está fazendo mais do que arrumação. Sem ele, a liberação acontece quando o GC resolver acontecer, o que, sob pressão alta de alocação, pode nunca ocorrer durante a vida útil do processo. Uma bridge que segura um file handle, um dispositivo ou um buffer unmanaged grande e depende de finalização é um vazamento com limpeza marcada, em tese, para o futuro.
Para construir isso: uma solução Windows com a biblioteca C++ nativa, um projeto de DLL C++/CLI com suporte a CLR habilitado, e uma aplicação .NET referenciando a DLL de interop. Os alvos de arquitetura precisam bater de ponta a ponta — uma bridge x86 carregada num host x64 falha no carregamento com uma BadImageFormatException que nomeia o assembly, não o descasamento; então confira Platform Target nos três projetos primeiro quando uma bridge “não funcionar”.
5. O Problema Real: Dois Modelos de Memória
Seção intitulada “5. O Problema Real: Dois Modelos de Memória”O lado C# cria uma bridge. A bridge cria um objeto nativo.
Quem o destrói?
O GC conhece o objeto gerenciado. Ele não tem conhecimento automático das semânticas de ownership de um ponteiro C++ arbitrário.
- Perder a referência ao recurso nativo sem liberá-lo → vazamento.
- Liberá-lo enquanto outra coisa ainda usa o endereço → bug de tempo de vida (use-after-free, e o sintoma aparece num caminho de código sem relação).
- Liberá-lo duas vezes → double free (corrupção de heap agora, crash depois, culpa atribuída ao módulo errado).
| Tipo de recurso | Quem é dono da liberação |
|---|---|
| Objeto C# comum | Coletor de Lixo |
| Objeto C++ na pilha | RAII, destrutor, saída de escopo |
std::unique_ptr<T> |
Ownership exclusivo, RAII |
std::shared_ptr<T> |
Ownership compartilhado, control block |
| Bridge C++/CLI detendo estado nativo | Liberação determinística, normalmente IDisposable |
A melhoria que se paga sozinha em aplicações maiores: manter o ownership real dentro de uma classe nativa usando std::unique_ptr, e deixar a bridge gerenciada guardar apenas um ponteiro para essa estrutura.
A lógica de recurso fica encapsulada no domínio C++; o C++/CLI é reduzido a controlar o tempo de vida da bridge. É uma diferença pequena no diagrama e grande na manutenção, porque no dia em que outra pessoa além de você editar o lado nativo, as regras de ownership continuam sendo impostas pelo sistema de tipos do C++ em vez de por convenção.
A regra que pega a maioria destes
Seção intitulada “A regra que pega a maioria destes”Antes de escrever qualquer wrapper, responda no papel: para cada recurso nativo que atravessa a fronteira, nomeie a única instrução que o libera, e nomeie todos os caminhos que podem chegar a essa instrução.
Se a resposta for “em algum lugar no chamador”, ou “o GC eventualmente”, ou “o destrutor, a menos que lance exceção antes”, existe um defeito esperando por um calendário. As três formas clássicas valem ser reconhecidas de vista:
- Meio-dono: a bridge cria o recurso, mas o chamador é documentado como “responsável por chamar
Close()”. Nenhum revisor lembra disso; nenhum compilador impõe. - Dono duplo: tanto o finalizador da bridge quanto um
Close()explícito apagam o ponteiro, e o ponteiro não é anulado. Funciona para sempre num caminho de código, corrompe o heap no segundo. - Endereço compartilhado: duas bridges guardam o mesmo
NativeEngine*. Os dois destrutores rodam. O segundo libera memória que o alocador já reutilizou.
6. Por Que Não Apenas Chamar C++ com P/Invoke?
Seção intitulada “6. Por Que Não Apenas Chamar C++ com P/Invoke?”Pergunta justa, e muitas vezes a resposta certa.
C# tem Platform Invocation Services. Você chama funções exportadas por DLLs nativas através de uma assinatura compatível com ABI C:
extern "C" __declspec(dllexport)int __cdecl Sum(int a, int b){ return a + b;}using System.Runtime.InteropServices;
public static class NativeMethods{ [DllImport( "NativeMath.dll", CallingConvention = CallingConvention.Cdecl )] public static extern int Sum(int a, int b);}int result = NativeMethods.Sum(10, 20);Sem projeto C++/CLI, sem DLL habilitada para CLR, e pode ser multiplataforma (a mesma forma de DllImport no Linux/macOS com __attribute__((visibility("default")))). Para um punhado de funções, essa é a escolha correta e apelar para um projeto C++/CLI é over-engineering.
Então por que usar bridge?
Porque funções nativas simples não são toda a complexidade de uma biblioteca C++. Considere uma API com classes, herança, objetos com estado, callbacks e tipos como std::string ou std::vector. Esses tipos não formam uma ABI estável que o P/Invoke possa consumir. O layout deles é definido pela implementação e muda com a biblioteca padrão, a versão do compilador e as flags de build.
Você pode esconder tudo isso atrás de uma API C com handles opacos — CreateEngine(), EngineCalculate(handle, …), DestroyEngine(handle). Esse é um desenho perfeitamente válido e, para muitos times, o melhor a longo prazo: uma superfície pequena, estável, agnóstica de linguagem, que sobrevive a upgrades de compilador e funciona a partir de Python, Rust ou de um binário de teste.
O custo é uma segunda interface que você agora projeta, implementa e mantém. O C++/CLI deixa você construir a bridge orientada a objetos diretamente sobre classes que você já tem, sem uma nova superfície C.
Qual usar
Seção intitulada “Qual usar”| Critério | P/Invoke | C++/CLI |
|---|---|---|
| API nativa simples em estilo C | Ideal | Possível, provavelmente desnecessário |
| Biblioteca com muitas classes C++ | Você precisa projetar uma superfície C | Adapta as classes existentes diretamente |
| Integração rica com tipos .NET | Marshaling explícito | Acesso direto a tipos gerenciados |
| Portabilidade | Pode ser multiplataforma | Só Windows |
| Evolução de longo prazo | Boa com uma ABI estável | Boa para Windows/.NET existentes |
| Complexidade de tempo de vida | Exige um contrato explícito | Exige um contrato explícito |
A última linha é a que as pessoas pulam. Nenhuma das duas tecnologias remove o problema de ownership. Elas oferecem ferramentas diferentes para resolvê-lo, e uma bridge escrita por alguém que não pensou em ownership vaza exatamente tanto quanto um DllImport escrito pela mesma pessoa. A tecnologia não é a propriedade de segurança.
7. Marshaling: os Dados Também Precisam Atravessar
Seção intitulada “7. Marshaling: os Dados Também Precisam Atravessar”int e double fazem o exemplo parecer fácil. Sistemas reais movem strings, arrays, buffers, structs e objetos.
Mover isso entre C# e C++ envolve marshaling — adaptar representações. Você pode ter um System::String^ de um lado e precisar de um std::string do outro. O C++/CLI te dá msclr::interop::marshal_as para isso.
O utilitário é a parte fácil. As decisões são a parte difícil, e uma conversão real de string força todas elas:
- Qual encoding? UTF-8, UTF-16 ou a code page ANSI.
marshal_as<std::string>sobre umSystem::String^faz uma conversão estreita que depende do locale corrente — uma decisão que você não tomou conscientemente. - Quem é dono do buffer resultante? Se o lado nativo guarda o ponteiro, alguém tem que liberá-lo, e esse alguém tem que ser o mesmo alocador que o produziu.
- Os dados precisam ser copiados? Para uma chamada somente leitura, pinar (
pin_ptr) evita uma cópia — ao custo de derrotar a compactação do GC durante o período. É uma troca real, não um ganho grátis. - Por quanto tempo um ponteiro é válido? Um ponteiro devolvido por um helper de marshaling pode estar amarrado ao tempo de vida de um temporário. Mantê-lo depois da chamada é um use-after-free que passa em todos os testes de debug.
- Sobrevive a não-ASCII? Essa é a que vai para produção. Uma aplicação funciona por anos com nomes em inglês e então recebe texto com acentos, um travessão ou um conjunto de caracteres que o desenvolvedor nunca testou. O bug aparece como mojibake na UI, ou como crash num cálculo de tamanho que assumia 1 byte por caractere.
A fronteira de interoperabilidade precisa de uma política de encoding escrita e testada com entrada não-ASCII. Uma única string de teste com caracteres acentuados, um emoji e uma amostra RTL teria pego mais bugs de interop do que qualquer quantidade de code review.
O mesmo vale para estruturas de dados. Se o lado C++ produz 50.000 registros e a UI os recebe uma chamada por vez, você projetou um cruzamento de fronteira por registro, e o custo da integração se torna o custo dominante. Uma API que devolve um lote costuma ser dramaticamente melhor que uma que devolve um item, porque o custo fixo de cruzar (transição, marshaling dos argumentos, preparação do tratamento de exceção) é amortizado em vez de pago 50.000 vezes.
Mas meça a decisão. Lote adiciona pressão de memória e uma superfície de serialização. “Fazer em lote” é uma hipótese, não uma regra.
8. Performance: O Interop É o Gargalo?
Seção intitulada “8. Performance: O Interop É o Gargalo?”Não necessariamente — e a pergunta costuma ser feita na direção errada.
Uma chamada gerenciado-para-nativo custa algo: overhead de transição, possível marshaling, e o fato de o JIT não poder aplicar inline ou devirtualizar através da fronteira, então ele não consegue otimizar a chamada como otimiza C# puro.
Dois cenários:
Cenário um. O usuário pede um cálculo que leva 300 ms. Você cruza a fronteira uma vez. O custo de transição é medido em nanossegundos. É ruído. A engine é o perfil.
Cenário dois. Um loop de renderização chama uma função nativa 2 milhões de vezes por segundo, convertendo uma string para wchar_t* em cada chamada. Aqui a transição e a conversão são a carga de trabalho, e nenhuma quantidade de otimização da engine ajuda.
Onde eu começaria a medir:
- Tempo dentro da biblioteca nativa (profiler nativo, não o gerenciado)
- Tempo em conversões de tipo e marshaling
- Número de cruzamentos de fronteira por operação
- Alocações e cópias atribuíveis à fronteira
- Latência percebida na UI — p95 e p99, não a média
Se a maior parte do tempo está dentro da biblioteca nativa, otimizar marshaling é distração. Se a aplicação faz milhares de chamadas minúsculas, lotes ou uma API de granularidade grossa é a correção.
A pergunta não é se C++/CLI é rápido. É para onde o tempo está indo — e a fronteira é apenas uma suspeita até você ter uma medição.
Um padrão que vale destacar porque parece otimização e é defeito: cachear um handle nativo entre chamadas para evitar “recriá-lo”. Se o objeto dono desse handle pode ser descartado por outra thread — ou pelo GC, se o wrapper foi finalizado — você trocou um custo medido por um use-after-free não medido. Cacheie ownership, não handles.
9. Exceções: Nunca Deixe a Fronteira Decidir por Você
Seção intitulada “9. Exceções: Nunca Deixe a Fronteira Decidir por Você”Uma biblioteca nativa lança std::runtime_error, std::invalid_argument e o que mais seus autores escolheram. A aplicação C# espera a hierarquia de exceções do .NET.
O contrato de interop tem que declarar quais falhas são traduzidas, como são comunicadas e o que o consumidor deve fazer:
- Entrada inválida → uma exceção que o chamador consegue tratar e mostrar a um usuário (
ArgumentException). - Falha externa transitória → possivelmente repetível; o tipo deve dizer isso (
IOException, umaTransientExceptioncustomizada). - Violação de invariante → um bug; registre com contexto e deixe falhar alto.
- Falha inesperada → preserve contexto suficiente para diagnosticar depois, sem vazar segredos na mensagem.
O que nunca é aceitável:
try{ return engine->Calculate(value, factor);}catch (...){ return 0.0; // sucesso e falha agora são indistinguíveis}Isso apaga a informação mais valiosa do sistema: se o cálculo realmente aconteceu. E zero costuma ser um resultado legítimo — o que significa que o chamador não consegue sequer detectar a falha olhando o valor.
Há uma segunda razão, mais sutil, para catch (...) numa fronteira ser perigoso: em C++/CLI, uma exceção gerenciada pode ser capturada por um catch (...) nativo. Engoli-la ali descarta uma exceção gerenciada que o código .NET estava preparado para tratar, e o stack trace vai junto.
E onde você expõe uma ABI C, nenhuma exceção C++ pode escapar de uma função que não tem maneira documentada de carregá-la. Através de extern "C", desenrolar para dentro de um chamador construído por outro compilador, com tabelas de exceção diferentes, é comportamento indefinido — pode funcionar por anos, e então quebrar numa máquina com um runtime diferente. Envolva o corpo em try/catch(...) e converta para um código de erro. Isso não é programação defensiva; é exigência da ABI.
| Falha nativa | Superfície .NET | Ação do chamador |
|---|---|---|
std::invalid_argument |
ArgumentException |
Corrigir a entrada, mostrar mensagem |
std::out_of_range |
ArgumentOutOfRangeException |
Limitar ou rejeitar |
std::bad_alloc |
OutOfMemoryException |
Falhar a operação, liberar caches |
| Falha de I/O | IOException |
Política de retry |
| Qualquer outra | InvalidOperationException + inner |
Registrar com contexto, falhar |
Exceção atravessando extern "C" |
(comportamento indefinido) | Nunca pode acontecer |
10. Quando a Aplicação Desktop Congela
Seção intitulada “10. Quando a Aplicação Desktop Congela”Outro problema comum em aplicações híbridas é responsividade, e normalmente é diagnosticado errado.
O usuário pede para carregar um modelo grande. C# chama C++, então espera o cálculo. Se essa chamada acontece na thread de UI, a janela fica branca e o Windows oferece fechá-la.
Adicionar async ao método C# não corrige isso. async é um mecanismo para reorganizar continuações; ele não cria uma thread. Uma chamada nativa síncrona dentro de um método async continua bloqueando a thread em que roda. Você adicionou overhead de máquina de estados e manteve o congelamento.
Você precisa decidir onde o trabalho roda:
- Para trabalho CPU-bound:
Task.Run(ou um scheduler dedicado) tira a chamada da thread de UI. Agora você precisa de controle de concorrência, cancelamento onde a API nativa suportar, e uma política clara para o tempo de vida de cada objeto envolvido — a engine nativa agora está sendo usada por uma thread do thread pool enquanto a UI pode querer descartá-la. - Para trabalho I/O-bound: assincronia de verdade exige uma API nativa que possa ser aguardada. Um
Read()bloqueante embrulhado emTask.Runconsome uma thread por chamada; com 200 operações concorrentes isso é esgotamento do thread pool, e a aplicação para de responder de um jeito que parece um bug completamente diferente.
Resultados precisam voltar à UI pelo mecanismo da própria framework — Dispatcher.Invoke/await do WPF no contexto de sincronização, ou a infraestrutura de invocação do Windows Forms. Tocar num controle a partir de uma thread de background lança InvalidOperationException no melhor caso e corrompe o handle da janela no pior.
E se duas chamadas podem atingir a mesma instância nativa em concorrência, você precisa saber se a implementação é thread-safe. A maior parte das bibliotecas C++ maduras não é, e a documentação que diz “não é thread-safe” é fácil de perder. Mover a chamada para outra thread não torna o objeto seguro; torna a corrida intermitente — o que é pior, porque passa no CI.
Política de concorrência pertence à arquitetura, não à thread que por acaso chama a função.
11. Depuração: Quando o Bug Está na Outra Linguagem
Seção intitulada “11. Depuração: Quando o Bug Está na Outra Linguagem”Numa aplicação C# com C++ nativo, um crash aparece na ponta da frente mesmo quando o defeito está na engine. Um ponteiro inválido, corrupção de heap ou um use-after-free podem produzir sintomas muito longe da causa — um número errado numa grade, um no-op silencioso, um crash em código que nunca foi editado.
A depuração precisa atravessar as camadas:
- Configure depuração em modo misto no Visual Studio para poder dar passo de C# para C++ e voltar.
- Gere símbolos (PDB) para todos os módulos envolvidos, incluindo os de terceiros quando disponíveis.
- Inspecione as duas pilhas — a gerenciada e a nativa — e aprenda a ler onde elas se encontram.
- Verifique compatibilidade de arquitetura (tudo
x64, ou tudox86). - Investigue o tempo de vida dos objetos que atravessam a integração, não apenas os valores.
- Use diagnósticos de memória adequados ao nativo — Application Verifier, PageHeap, AddressSanitizer onde couber, heap de debug do CRT.
- Correlacione logs entre a UI e a engine de processamento com um id de correlação compartilhado. Sem ele, você fica casando timestamps na mão.
Um padrão que vale reconhecer de vista: a UI funciona no primeiro cálculo e falha só quando o usuário roda a mesma operação de novo. Essa é uma assinatura de tempo de vida — um objeto foi destruído, e algo ainda guarda uma referência que permite acessá-lo. “O segundo clique fecha a aplicação” é um sintoma; a investigação tem que responder quem criou o objeto, quem poderia tê-lo destruído, e o que estava acessando-o quando ele morreu.
O segundo padrão: só falha em Release. Normalmente é um bug de tempo de vida visível ao otimizador — o último uso do objeto está em código nativo e você manteve um ponteiro depois disso, o que o Debug não percebe porque a memória ainda está intacta.
12. Como Eu Testaria Esta Integração
Seção intitulada “12. Como Eu Testaria Esta Integração”Um desenho bom o suficiente para ser testado é um desenho bom o suficiente para ser seu. Cada camada, separadamente:
A biblioteca nativa. Testes unitários sobre algoritmos e regras de domínio, sem UI e sem CLR. É a maior superfície de teste e a mais barata de rodar — e também deve ser a maior fonte de confiança.
A bridge. Testes de integração sobre a fronteira em si:
| Cenário | Esperado |
|---|---|
| Parâmetros válidos | Resultado correto |
| Entrada inválida | O tipo específico de exceção .NET |
| Objeto já descartado | ObjectDisposedException |
| Descarte duplo | Sem double free, sem crash |
| Descarte depois que o finalizador rodou | Sem double free |
| Falha inesperada da engine | Erro observável com contexto |
| Chamadas concorrentes | Comportamento definido pelo contrato |
| Criar/descartar repetidamente | Sem crescimento anormal em recursos nativos |
| Entrada de string não-ASCII | Ida e volta corretas |
A linha “criar/descartar repetidamente” é a que pega os vazamentos. Faça isso 10.000 vezes e observe a contagem de handles ou os bytes privados do processo. Uma curva de crescimento lenta é visível num teste e invisível numa demonstração.
A UI. Testes de que operações lentas não deixam a aplicação permanentemente bloqueada, de que erros aparecem como mensagens em vez de falhas silenciosas, e de que fechar a janela durante uma operação longa descarta a engine em vez de competir com ela.
Nem tudo pode ser automatizado com testes unitários. Alguns defeitos de interop exigem execuções de integração reais, diagnósticos de memória e uma configuração Windows equivalente à de produção. E teste também o caminho de instalação e upgrade: uma aplicação híbrida depende de distribuir corretamente assemblies gerenciados, DLLs nativas e runtimes — uma bridge que funciona na máquina de desenvolvimento e falha na do cliente normalmente é um redistribuível x64 faltando ou uma DLL carregada do diretório errado.
13. C++/CLI Ainda Vale a Pena?
Seção intitulada “13. C++/CLI Ainda Vale a Pena?”Sim, condicionalmente.
Se uma empresa tem uma biblioteca C++ grande, madura e valiosa, reescrevê-la em C# para facilitar a UI introduz risco sem retorno de produto. Uma camada de interop preserva a implementação e expõe suas capacidades ao .NET. É uma escolha de engenharia real e defensável, especialmente em software desktop de engenharia, aplicações industriais e sistemas que integram componentes nativos especializados.
Também é verdade: C++/CLI é presa ao Windows. No .NET moderno, projetos C++/CLI carregam restrições próprias de build e distribuição, e não podem ser compilados cruzado a partir do Linux. A orientação da própria Microsoft aponta o desenvolvimento novo para outras opções — particularmente quando portabilidade e evolução de plataforma no longo prazo são prioridades.
Para sistemas novos, considere uma ABI C com P/Invoke, bindings gerados (CSnakes, ClangSharp ou geradores no estilo SWIG) ou separação de processos — um serviço nativo pequeno com um contrato IPC. Separação de processos é subestimada: dá isolamento de crash, implantação independente e uma fronteira agnóstica de linguagem, ao custo de serialização e latência de IPC. Para uma engine de cálculo que leva 300 ms, esse custo é irrelevante. Para um callback por frame, é impossível.
A melhor ferramenta não é a mais nova. É a que preserva seus contratos, controla seus recursos e deixa o sistema evoluir sem multiplicar seus pontos de falha. Para uma casa Windows com um core C++ existente, o C++/CLI muitas vezes ainda ganha essa comparação.
14. O Que Eu Procuro em Code Review
Seção intitulada “14. O Que Eu Procuro em Code Review”Revisando uma integração C# ↔ C++, começo por perguntas objetivas, porque as subjetivas (“isso está limpo?”) produzem opiniões em vez de defeitos:
- Quem é dono de cada recurso nativo? Nomeie o dono de cada ponteiro.
- A liberação ainda acontece se uma exceção for lançada no meio da operação?
- O acesso é possível depois do
Dispose? A checagem de null é a única guarda, e é feita antes de todo uso? - O contrato de erro distingue entrada inválida de falha interna?
- Strings e buffers têm encoding e tempo de vida definidos?
- Chamadas concorrentes são permitidas? Isso está escrito ou assumido?
- A UI pode bloquear?
- A integração faz cópias ou cruzamentos excessivos?
- Está testada contra o mesmo runtime e arquitetura da produção?
A parte interessante: quase nenhuma dessas perguntas é específica de C++/CLI. São perguntas de engenharia de software. A tecnologia só torna as consequências mais visíveis — e menos tolerantes.
Conclusão: A Fronteira Faz Parte da Arquitetura
Seção intitulada “Conclusão: A Fronteira Faz Parte da Arquitetura”Conectar C# e C++ não é difícil quando o problema é chamar uma função que recebe dois números.
A dificuldade chega com estado, recursos, concorrência, exceções e a necessidade de continuar evoluindo.
O CLR não revoga as regras de tempo de vida do C++. O RAII do C++ não faz o coletor de lixo desaparecer. Dois modelos têm que se encontrar num contrato que diga exatamente onde cada responsabilidade começa e termina — e alguém tem que escrever esse contrato, porque um contrato que existe só na cabeça do autor original é um bug com data de entrega.
Minha abordagem: manter a lógica de domínio em C++ nativo, expor uma interface gerenciada pequena e estável, documentar ownership, traduzir erros explicitamente e medir o custo da integração antes de tentar otimizá-la. Quase todo desastre de performance que eu vi em sistemas híbridos foi causado por uma otimização não medida que introduziu um bug de ownership, não por a fronteira ser lenta.
Uma boa camada de interoperabilidade não é a que deixa você chamar tudo. É a que deixa claro o que pode ser chamado, quem é responsável pelo resultado e o que acontece quando algo dá errado.
Esse princípio se aplica a qualquer sistema híbrido — uma aplicação Windows tradicional, uma engine de cálculo ou uma ferramenta CAD.
Continue Lendo
Seção intitulada “Continue Lendo”- C++/CLI e Interop — a edição em inglês deste artigo
- RAII em C++ — Ownership Como Tipo, Não Como Convenção — a metade nativa do argumento deste artigo, em profundidade.
- Smart Pointers em C++ — unique_ptr, shared_ptr e weak_ptr — como manter o ownership real dentro da classe nativa.
- Paralelismo vs. Concorrência — o que “é thread-safe?” realmente pergunta.
- C++ em High-Frequency Trading — por que limpeza determinística importa quando nanossegundos são dinheiro.
- A Trilha de Aprendizado C++ — o módulo de ownership, exercícios e um checklist gratuito de modernização.
Referências
Seção intitulada “Referências”- Microsoft Learn — Native and .NET Interoperability
- Microsoft Learn — .NET Programming with C++/CLI
- Microsoft Learn — How to Port C++/CLI Projects to .NET
- Microsoft Learn — How to: Define and Consume Classes and Structs (C++/CLI)
- Microsoft Learn — Overview of Marshaling in C++
- Microsoft Learn — Managed Exceptions and Interop
Todo recurso nativo que você adquire é uma promessa de liberá-lo exatamente uma vez. A fronteira é onde essa promessa ou ganha um contrato, ou é esquecida.